Nano Banana 2,
qualidade Pro na velocidade Flash
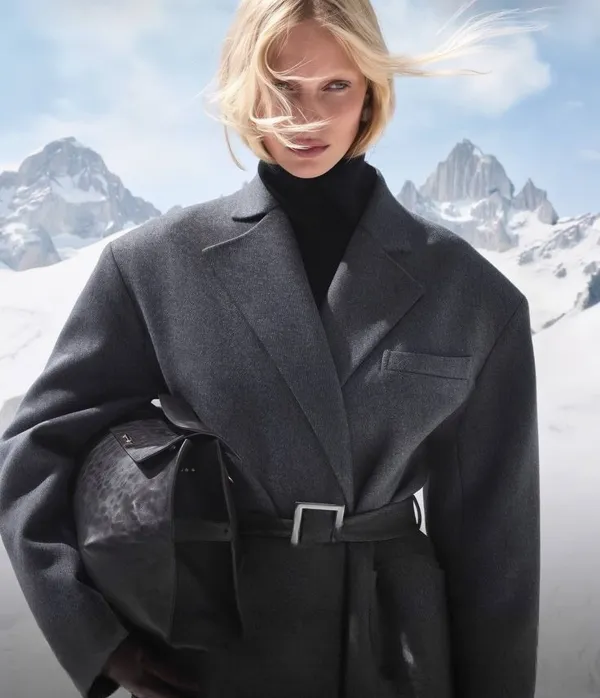
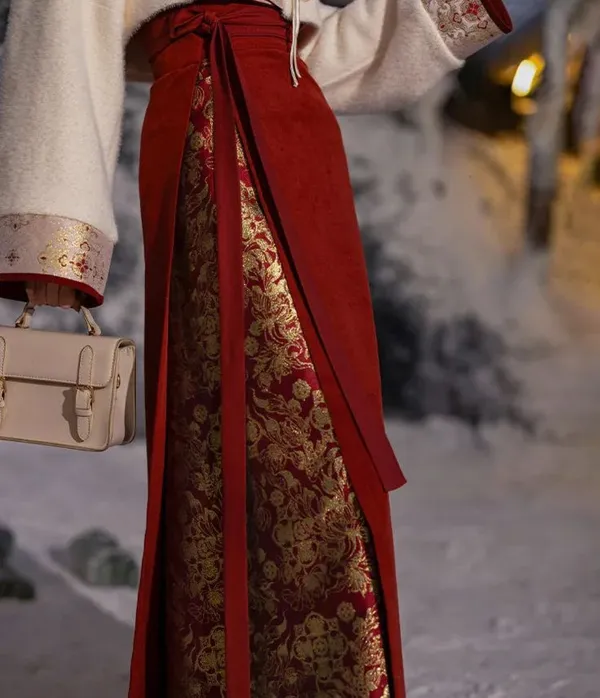
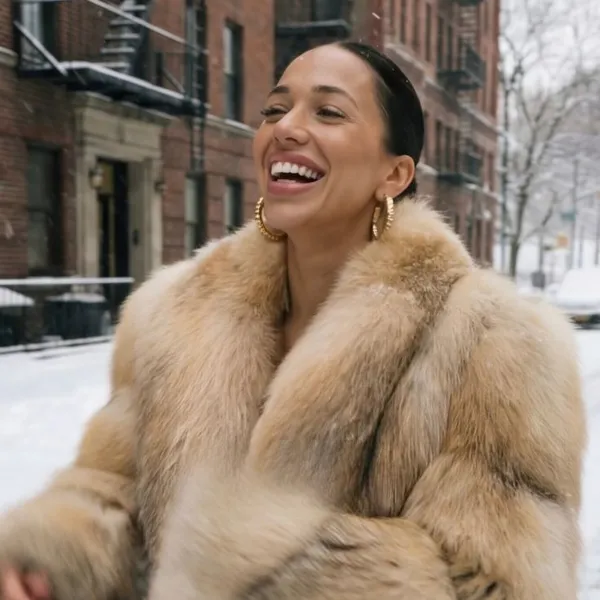
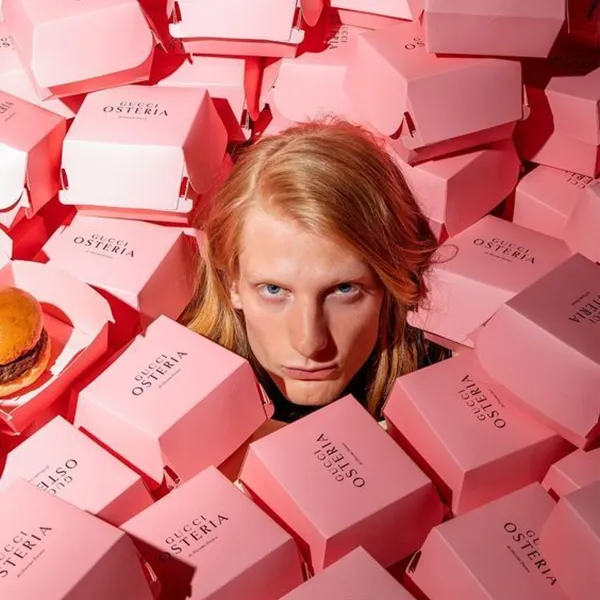
O Nano Banana 2 é o modelo de imagem mais novo do Google e já está na Azurade AI, texto que sai legível, personagem que continua o mesmo de uma imagem pra outra, resolução até 4K, e rápido
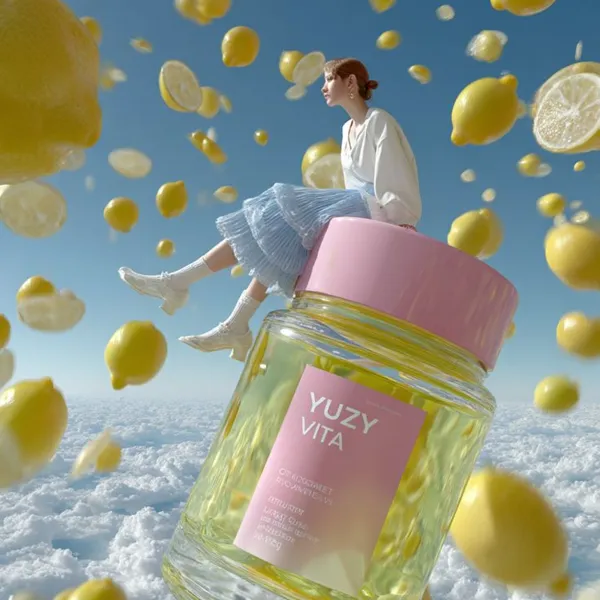
Nossas vantagens
Todo modelo, uma conta só
45 modelos, Nano Banana, Seedream, Veo, Wan, todos atrás de um login e um saldo só, em vez de uma assinatura separada pra cada um.
Preços baixos
Nano Banana a partir de R$ 0,21 por imagem, Wan 2.7 a partir de R$ 4,15 por clipe de cinco segundos, você paga por geração e pronto.
Os modelos de IA mais recentes
Veo 3.1, Seedance 2.5, Nano Banana Pro e outros modelos recentes.
Ferramentas para a próxima geração de criadores
Geração com IA rápida e de qualidade, com controle sobre o resultado, numa plataforma só.
Texto preciso e tradução direto na imagem
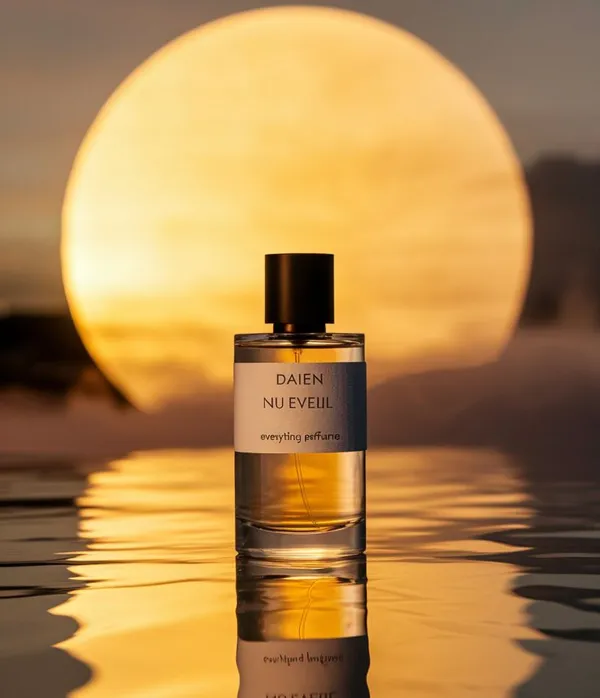
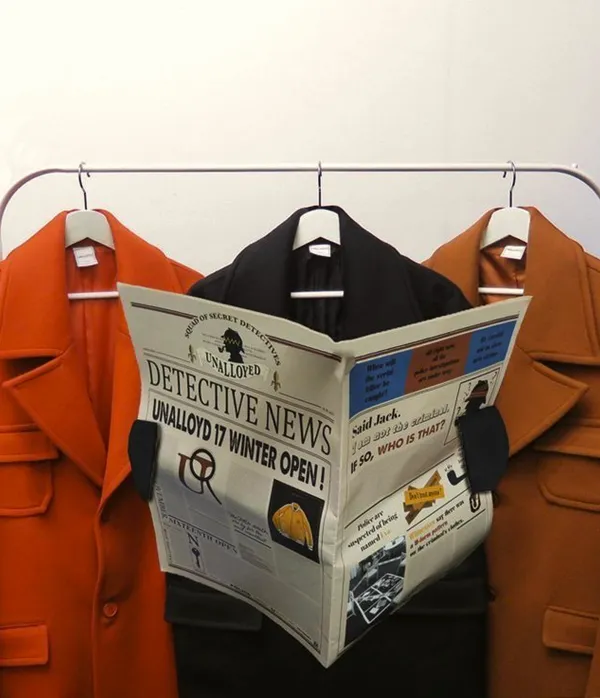
O Nano Banana 2 coloca texto nítido e legível direto na imagem, bom pra peça de marketing, cartão-postal e infográfico. Ele também traduz e adapta o texto que já está na imagem, então a mesma arte serve em vários idiomas.
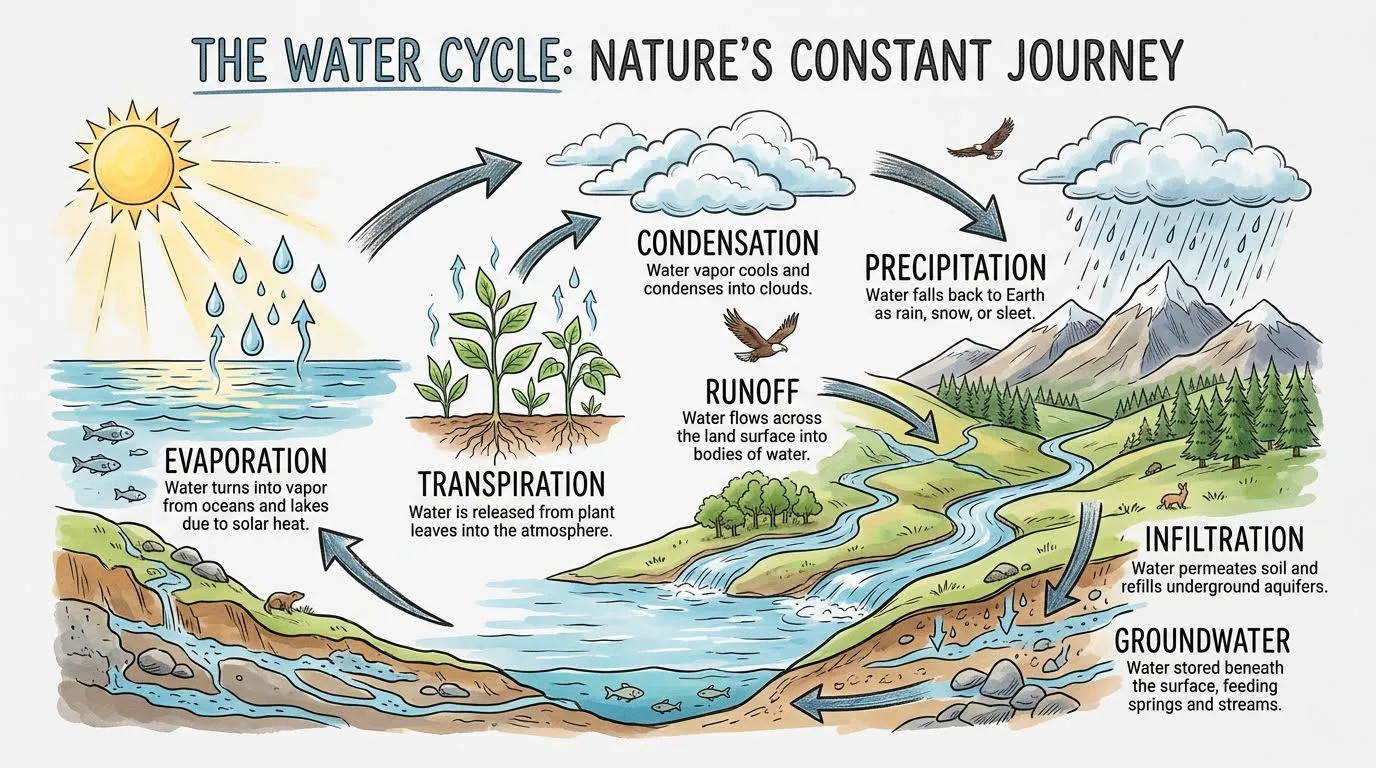
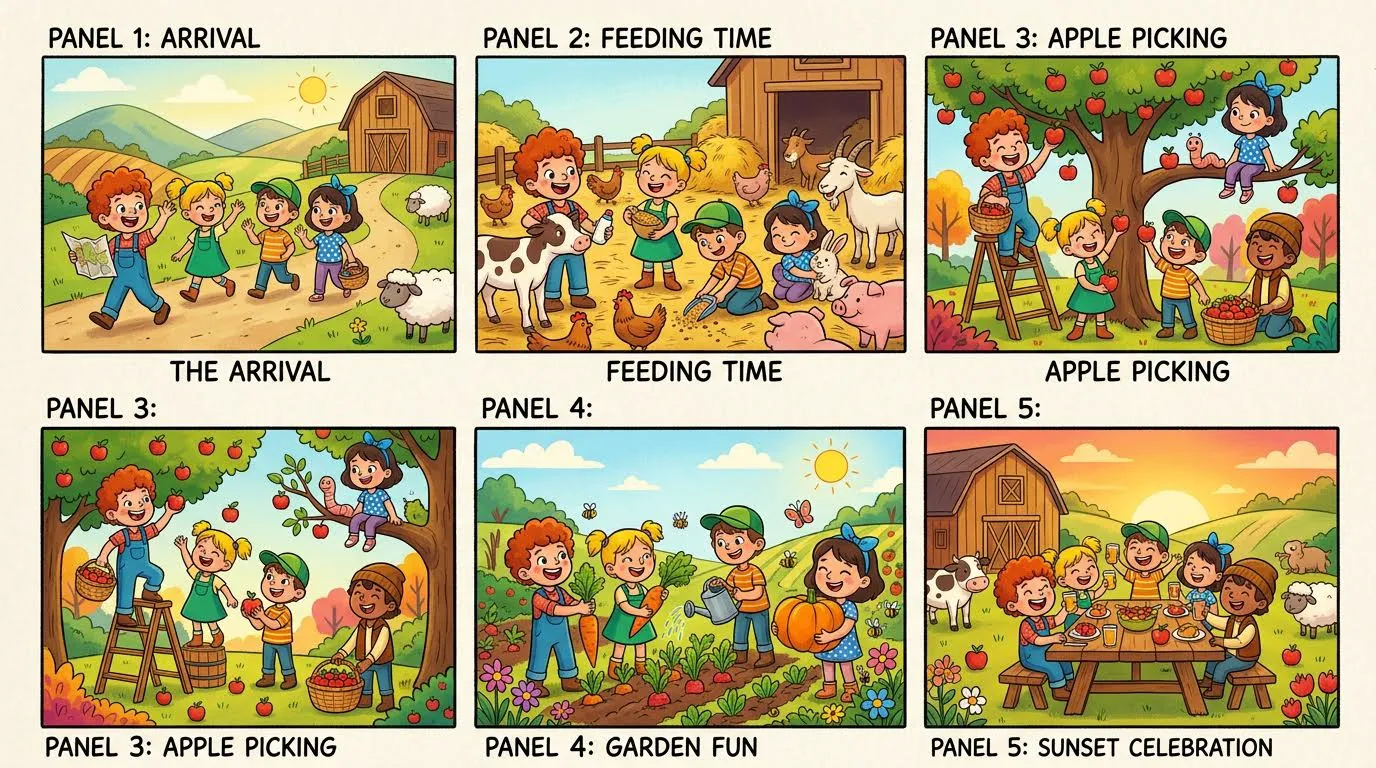
Consistência de personagens e objetos
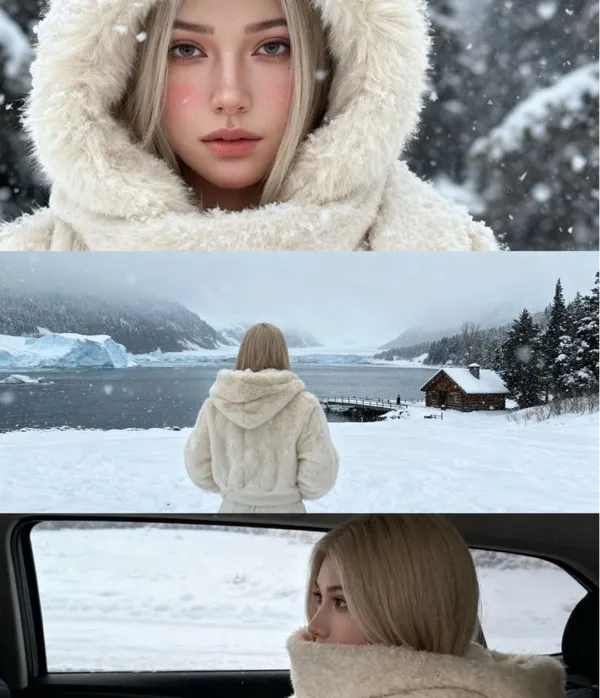
Até 5 personagens mantêm a aparência e até 14 objetos continuam fiéis no mesmo fluxo de trabalho, então dá pra montar um storyboard ou contar uma história inteira sem ninguém mudar de um quadro pro outro.
Qualidade de produção até 4K
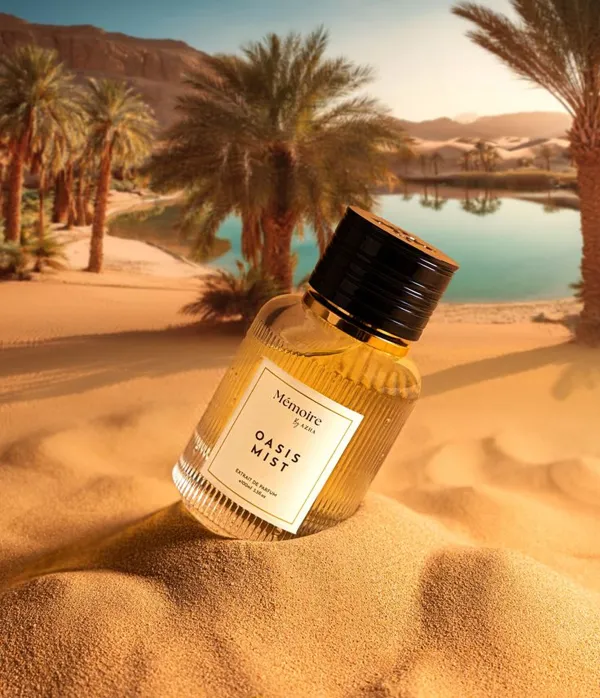
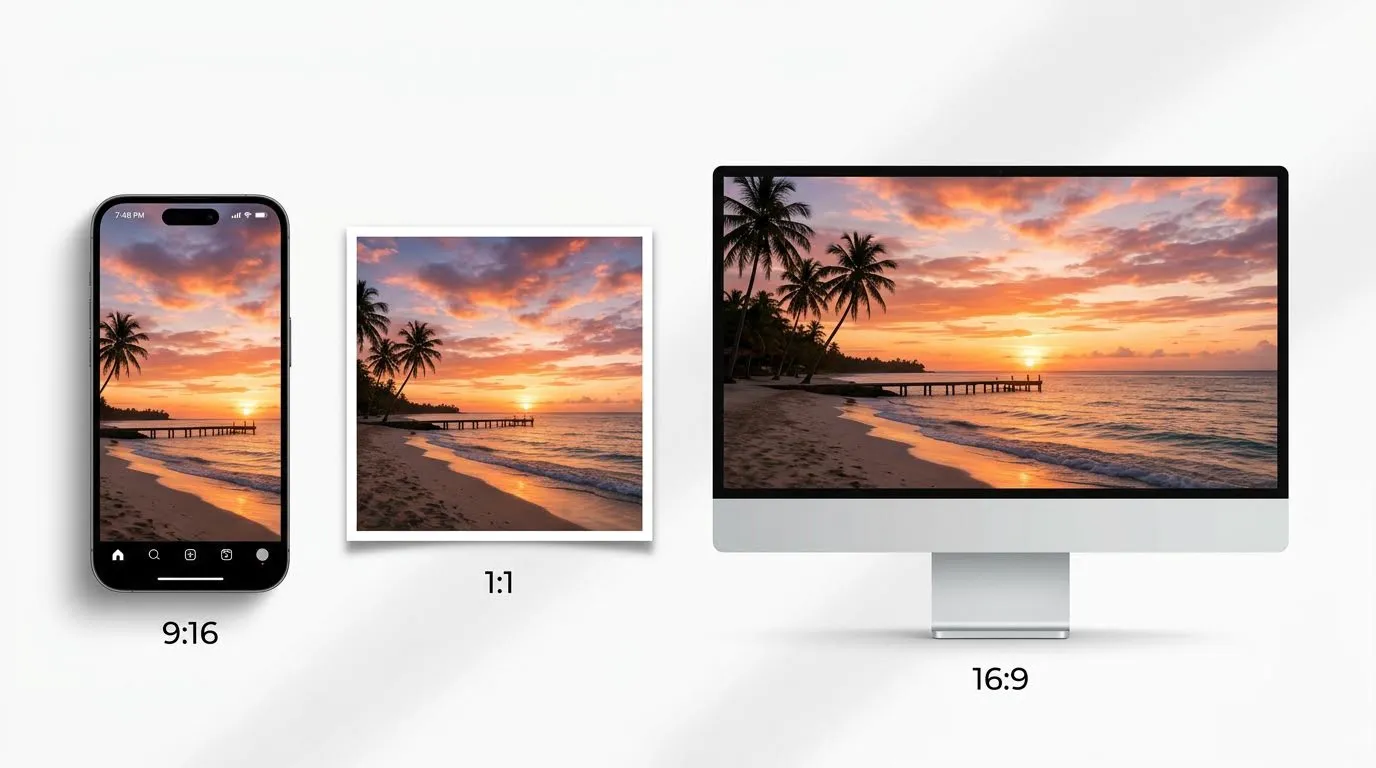
Escolha qualquer resolução de 512px a 4K e defina a proporção do seu jeito. Luz clara, textura rica e detalhe nítido se mantêm em qualquer tamanho.
Edição e reestilização de imagem
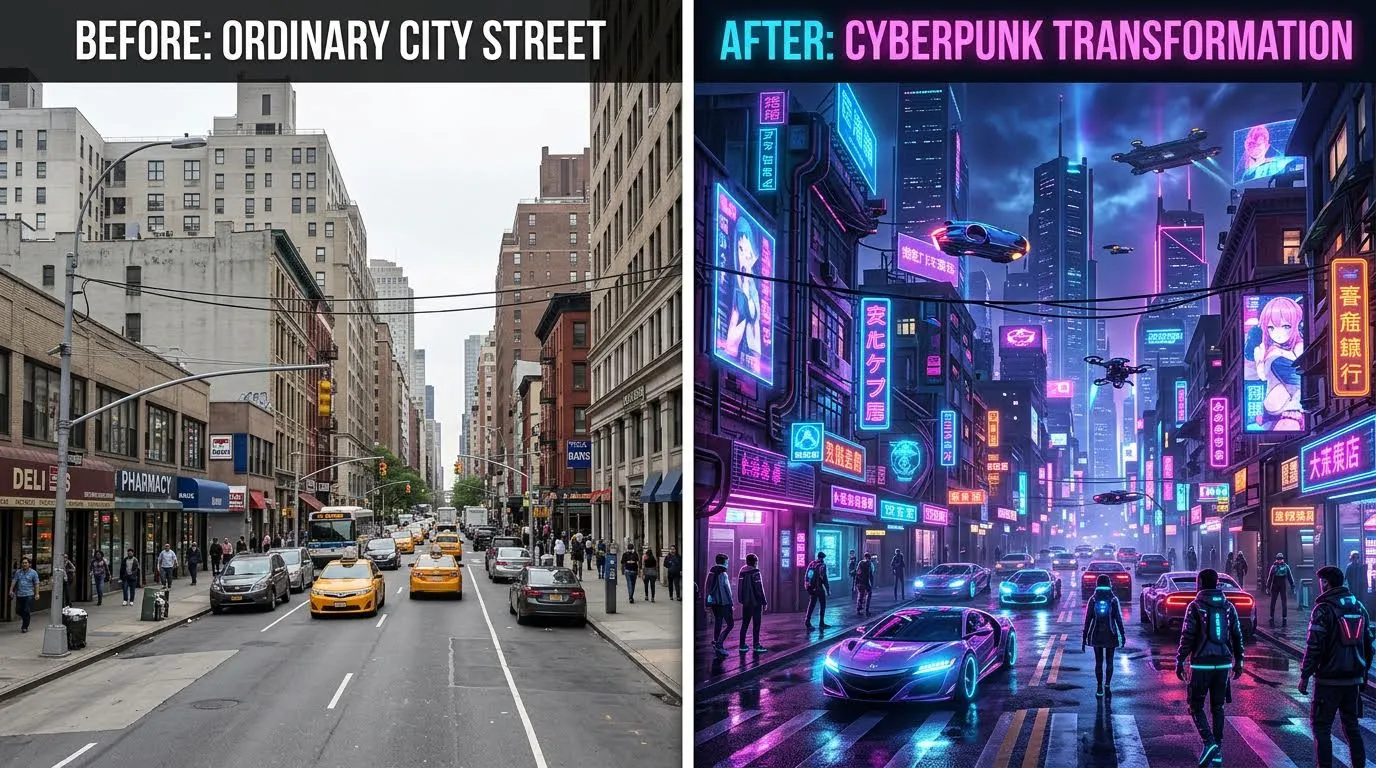
Envie uma foto e mude o estilo, coloque ou tire coisas, ou leve um objeto pra outra cena. O Nano Banana 2 entende o contexto, então o resto da imagem fica intacto na edição.
Conhecimento profundo do mundo real
O modelo usa uma base de conhecimento grande e busca em tempo real, então objetos e lugares específicos saem certos. Use pra infográfico, pra transformar anotação em diagrama ou pra visualizar dados com poucas alucinações.
Perguntas frequentes
Como resolver os pedidos mais comuns num gerador de imagem com IA
Dá pra gerar uma imagem com fundo transparente?
Dá. Gera num fundo liso e depois roda a remoção de fundo, que devolve um PNG com transparência de verdade, pronto pra entrar num banner, num anúncio ou num slide.
Dá pra seguir as cores e o estilo da minha marca?
Dá. Coloca os códigos hex e a linguagem visual no prompt e sobe uma referência se tiver. O que precisa ser exato no pixel, tipo o logo ou o nome da marca, fica melhor posicionado no editor depois de gerar a cena do que desenhado pelo modelo.
Dá pra remover um objeto indesejado de uma foto?
Dá. Sobe a foto e descreve o que tem que sair, seja um pedestre, um cabo ou um reflexo, e o modelo preenche o espaço com o que provavelmente estava atrás, que costuma ficar mais limpo que um carimbo manual.
Dá pra gerar um conjunto de imagens que combinam entre si?
Dá. Mantém o mesmo modelo e a mesma descrição de luz e de fundo, e muda só a linha do assunto no prompt. É assim que um cardápio, um catálogo ou uma campanha sai com cara de fotografado numa sessão só.
Dá pra gerar imagem em resolução de impressão?
Dá. Ajusta a proporção pro tamanho final, gera no maior tamanho que o modelo oferece e depois amplia, o que dá pixel suficiente pra pôster, embalagem e formato grande.
A IA consegue restaurar ou colorir uma foto antiga?
Consegue. Sobe o escaneado e pede reparo de danos, nitidez ou colorização. Rosto e roupa saem melhor, e área muito destruída ganha uma reconstrução plausível, não o detalhe original, então o resultado não vale como registro do que estava lá.